
Keras 的简单随机权重平均回调。

项目描述
Keras SWA - 随机权重平均


这是针对 Keras 和 TF-Keras 的 SWA 实现。
介绍
随机权重平均 (SWA) 建立在与快照集成和快速几何集成相同的原理之上。这个想法是平均选择训练阶段可以产生更好的模型。前两种方法通过采样和集成模型进行平均,而 SWA 取而代之的是平均权重。这已被证明可以在单个模型中提供类似的改进。
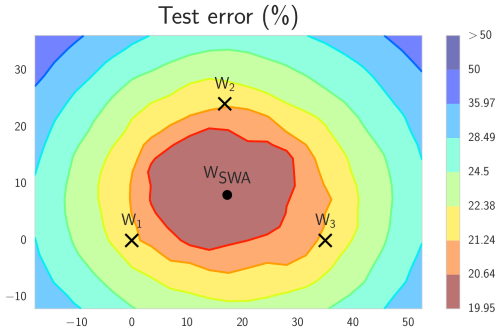
纸
- 标题:平均权重导致更广泛的最优和更好的泛化
- 链接:https ://arxiv.org/abs/1803.05407
- 作者:Pavel Izmailov、Dmitrii Podoprikhin、Timur Garipov、Dmitry Vetrov、Andrew Gordon Wilson
- 回购:https ://github.com/timgaripov/swa (PyTorch)
安装
pip install keras-swa
SWA API
SWA 的 Keras 回调对象。
论据
start_epoch - SWA 的起始纪元。
lr_schedule - 学习率计划。'manual','constant'或'cyclic'.
swa_lr - 平均权重时使用的学习率。
swa_lr2 - 循环调度的学习率上限。
swa_freq - 权重平均的频率。与循环调度一起使用。
batch_size - 正在使用批量大小模型进行训练(仅在使用批量标准化时)。
详细- 详细模式,0 或 1。
批量标准化
最后一个 epoch 将是前向传递,即对于具有批量标准化的模型,将学习率设置为零。这是因为批量归一化使用其前一层的运行均值和方差来进行归一化。SWA 将通过在训练结束时突然改变权重来抵消这种标准化。因此,有必要使用最后一个 epoch 来重置和重新计算更新权重的批归一化运行均值和方差。批量归一化 gamma 和 beta 值被保留。
使用手动调度时:如果使用批量标准化,SWA 回调将在最后一个 epoch 将学习率设置为零。任何外部学习率调度程序都不得撤消此操作,以使 SWA 正常工作。
学习率表
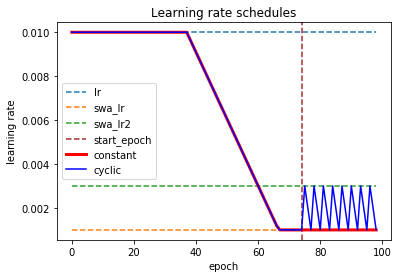
默认调度是'manual',允许学习率由外部学习率调度程序或优化器控制。如果使用批量归一化,SWA 只会影响最后一个 epoch 的最终权重和学习率。两个预定义的时间表,'constant'或者'cyclic'可以在下面观察。
例子
对于 Tensorflow Keras(具有恒定 LR)
from sklearn.datasets import make_blobs
from tensorflow.keras.utils import to_categorical
from tensorflow.keras.models import Sequential
from tensorflow.keras.layers import Dense
from tensorflow.keras.optimizers import SGD

from swa.tfkeras import SWA

# make dataset
X, y = make_blobs(n_samples=1000,
                  centers=3,
                  n_features=2,
                  cluster_std=2,
                  random_state=2)

y = to_categorical(y)

# build model
model = Sequential()
model.add(Dense(50, input_dim=2, activation='relu'))
model.add(Dense(3, activation='softmax'))

model.compile(loss='categorical_crossentropy',
              optimizer=SGD(lr=0.1))

epochs = 100
start_epoch = 75

# define swa callback
swa = SWA(start_epoch=start_epoch,
          lr_schedule='constant',
          swa_lr=0.01,
          verbose=1)

# train
model.fit(X, y, epochs=epochs, verbose=1, callbacks=[swa])
或者对于 Keras(带有 Cyclic LR)
from sklearn.datasets import make_blobs
from keras.utils import to_categorical
from keras.models import Sequential
from keras.layers import Dense, BatchNormalization
from keras.optimizers import SGD

from swa.keras import SWA

# make dataset
X, y = make_blobs(n_samples=1000,
                  centers=3,
                  n_features=2,
                  cluster_std=2,
                  random_state=2)

y = to_categorical(y)

# build model
model = Sequential()
model.add(Dense(50, input_dim=2, activation='relu'))
model.add(BatchNormalization())
model.add(Dense(3, activation='softmax'))

model.compile(loss='categorical_crossentropy',
              optimizer=SGD(learning_rate=0.1))

epochs = 100
start_epoch = 75

# define swa callback
swa = SWA(start_epoch=start_epoch,
          lr_schedule='cyclic',
          swa_lr=0.001,
          swa_lr2=0.003,
          swa_freq=3,
          batch_size=32, # needed when using batch norm
          verbose=1)

# train
model.fit(X, y, batch_size=32, epochs=epochs, verbose=1, callbacks=[swa])
输出
Model uses batch normalization. SWA will require last epoch to be a forward pass and will run with no learning rate
Epoch 1/100
1000/1000 [==============================] - 1s 547us/sample - loss: 0.5529
Epoch 2/100
1000/1000 [==============================] - 0s 160us/sample - loss: 0.4720
...
Epoch 74/100
1000/1000 [==============================] - 0s 160us/sample - loss: 0.4249

Epoch 00075: starting stochastic weight averaging
Epoch 75/100
1000/1000 [==============================] - 0s 164us/sample - loss: 0.4357
Epoch 76/100
1000/1000 [==============================] - 0s 165us/sample - loss: 0.4209
...
Epoch 99/100
1000/1000 [==============================] - 0s 167us/sample - loss: 0.4263

Epoch 00100: final model weights set to stochastic weight average

Epoch 00100: reinitializing batch normalization layers

Epoch 00100: running forward pass to adjust batch normalization
Epoch 100/100
1000/1000 [==============================] - 0s 166us/sample - loss: 0.4408

